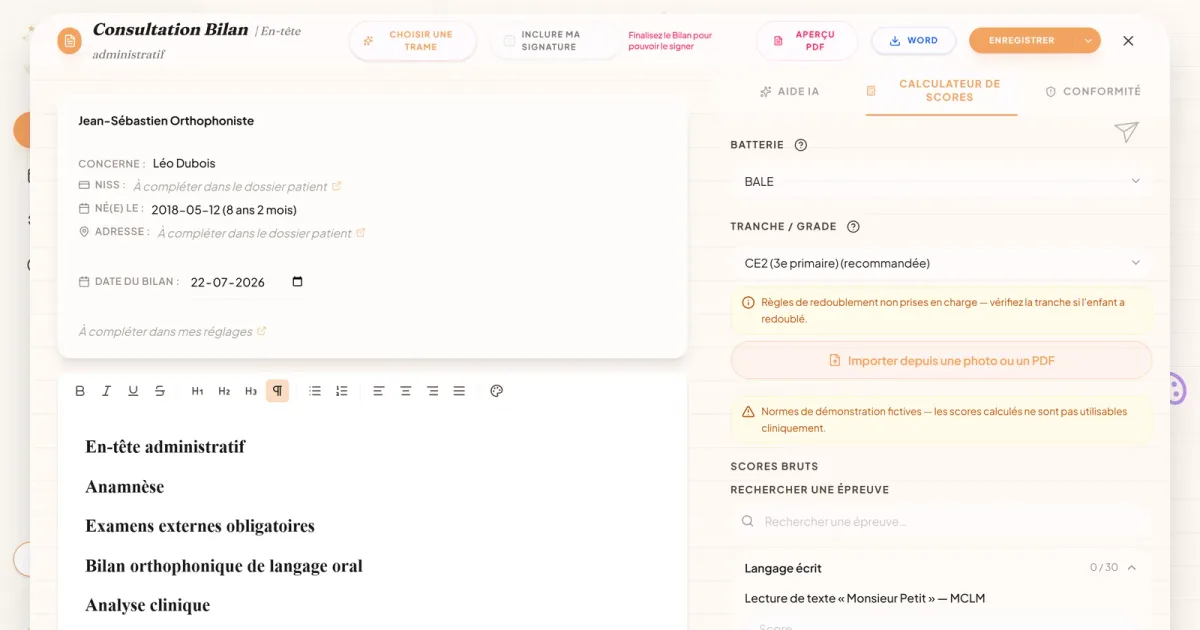
Orthopy est un logiciel clinique pour logopèdes, en bêta fermée sur orthopy.be depuis le 11 septembre 2026. L'étude de cas grand public raconte le produit. Cet article raconte la machine : le socle, la modélisation d'un métier réglementé, la chaîne de production à base d'agents, les trois pièces dont je suis le plus fier, ce qui a mal tourné et la mise en ligne.
Ordres de grandeur au 13 septembre 2026 :
| Indicateur | Valeur |
|---|---|
| Premier commit → mise en ligne | 10 avril → 11 septembre 2026 |
| Commits | 2 935 |
| Cycles de développement | 429 |
| Décisions d'architecture (ADR) | 43 |
| Migrations de base de données | 100 |
| Tests backend (pytest) | 3 385 |
| Tests frontend (Vitest) | 1 615 |
1. Les contraintes de départ
- Des données de santé d'enfants. Le patient type est mineur ; chaque décision de conception part de là.
- Un métier réglementé qui bouge. Listes de tests révisées, barème millésimé, nomenclature modifiée : rien qu'en 2026, les règles de la logopédie INAMI ont changé en janvier, en juillet et en septembre.
- Un développeur seul, un budget d'infrastructure proche de zéro et une logopède consultante clinique pour le terrain.
- Des agents IA pour écrire le code. Produire du code est devenu rapide ; prouver qu'il est juste ne l'est pas. Toute l'architecture du projet découle de ce déplacement.
2. Le socle (avril 2026)
Le document d'architecture initial date du 10 avril 2026. Ses choix structurants tiennent toujours :
- Monorepo
client/+server/+shared/pour les contrats et constantes partagés. - Backend FastAPI, SQLAlchemy 2.0 entièrement asynchrone, migrations exclusivement par Alembic.
- Frontend Next.js 16 (App Router), React 19, TypeScript et Tailwind.
- SQLite en développement, PostgreSQL en production, avec une couche base pilotée par URL dès le premier jour : la bascule devait être un changement de configuration, pas une réécriture.
- Authentification maison : jetons d'accès et de rafraîchissement, bcrypt, puis révocation côté serveur et double facteur TOTP.
- Les règles métier en données : registre INAMI, barème et grilles d'étalonnage en YAML versionné, relus en diff comme du code.
- Une décision structurante, un ADR.
Deux choses ont changé en route. Le fournisseur de modèles de langage initial a été retiré en août au profit de Mistral, hébergé dans l'UE (ADR-0032). Et le rôle de SQLite a été recadré : il ne sert plus que de base en mémoire ultrarapide pour boucler les 3 300 tests unitaires locaux en quelques secondes pendant les cycles de TDD. Dès que la logique touche aux contraintes, aux types stricts (Numeric, dates) ou à la concurrence, la CI backend, la pile Docker locale et la production tournent sur le même PostgreSQL 16.
Les principes de conception sont écrits dans un brief relu avant chaque tâche : modules profonds au sens de John Ousterhout (interface simple, implémentation riche), pas d'abstraction avant deux implémentations réelles, et remplacer plutôt qu'empiler quand un module est réécrit.
3. Faire tenir tout un métier dans un seul logiciel
Le plus gros du travail n'a pas été technique : il a consisté à faire tenir un métier entier dans un modèle cohérent. Bilans, batteries de tests, normes, règles INAMI, demandes d'accord, dossier mutuelle, agenda, plans de traitement, facturation, portail patient. Six principes l'ont rendu possible.
Un vocabulaire unique, imposé à tous les agents
CONTEXT.md définit une trentaine de termes métier, chacun en une phrase, avec les synonymes à éviter. Un Bilan est l'évaluation, le Compte-rendu est le document qui en sort. Une Norme est un étalonnage clinique, un Barème est un tarif en euros : les confondre est relevé en revue. Quand plusieurs agents écrivent dans le même dépôt, un vocabulaire flou produit un modèle de données flou.
Arbitrage fiabilité, complexité et délai : les règles INAMI en données pures
Face à une réglementation dense, l'alternative classique consiste soit à confier la logique à un LLM via un RAG, soit à développer un moteur d'inférence en graphes sur-mesure. Les deux options étaient des impasses :
- Un LLM n'offre aucune garantie déterministe sur un seuil de percentile : une hallucination de 1 % signifie un dossier rejeté par la mutuelle et une praticienne sanctionnée.
- Un moteur de règles complexe ajoute 1 500 lignes de logique interne à maintenir et durcit la base inutilement.
L'arbitrage retenu a privilégié la fiabilité maximale et le délai minimal : traiter les règles métier comme de la donnée brute en YAML.
Le registre INAMI compte 85 tests sur 7 domaines : 26 en langage oral, 16 en dyslexie, 11 en dysorthographie, 10 en bégaiement, 8 pour la voix, 7 en dyscalculie et 7 pour le QI, chacun avec sa catégorie et ses critères. Chaque fichier porte l'URL de la liste INAMI dont il est tiré et sa date d'entrée en vigueur. Le barème 2026 transcrit 123 codes de nomenclature, et il est millésimé : un barème ne s'écrase jamais, c'est la date de la prestation qui sélectionne le bon.
La règle de suffisance d'un bilan illustre l'approche. Pour la plupart des domaines, un bilan n'est transmissible que sur une combinaison catégorielle des tests réellement utilisés (un test C, ou deux tests A, ou un A et un B), et si au moins un test atteint son critère. Les catégories, les seuils d'âge et les critères sont lus dans les données, jamais recopiés dans le code :
# Extrait de server/data/inami/dyslexie.yaml
domain: dyslexie
nomenclature_code: "B3"
valid_from: "2025-03-01"
tests:
  - test_code: BELO__LECTURE
    category: A
    age_min_months: 72
    age_max_months: 108
    criteria_type: percentile
    criteria_threshold: 16
    criteria_direction: leq
    is_sufficient_alone: false
Résultat mesuré : 100 % déterministe, zéro coût d'inférence, couvert par des tests unitaires exécutés en moins de deux secondes. Et quand l'INAMI a révisé ses listes en janvier, en juillet et en septembre 2026, la mise à jour s'est faite en 15 minutes par simple diff git, sans toucher à une ligne de code d'API.
Des machines à états pour les cycles de vie
Un dossier mutuelle traverse des statuts précis : bilan en brouillon, bilan complet, envoyé, accord en attente, accordé ou refusé, actif, expiré. Les transitions autorisées sont déclarées par pays, et un changement de statut impossible est refusé avec un message lisible, affiché tel quel à la logopède sans perdre sa saisie.
Figer ce qui engage
Une facture fige ses trois montants à sa création, en Numeric(10,2) de bout en bout et jamais en flottant : c'est une pièce comptable, elle ne se recalcule pas à l'affichage (ADR-0019). Un compte-rendu finalisé fige son en-tête et sa trame. Un score fige la norme qui l'a produit.
La machine calcule, la professionnelle décide
Orthopy ne choisit jamais le code de nomenclature à la place de la logopède. Les critères d'une annexe sont cochés par elle : la valeur calculée reste affichée à côté, mais c'est sa décision qui part sur le document (ADR-0043). Quand l'import de normes par OCR lit deux valeurs contradictoires pour le même sous-test, rien n'est enregistré tant qu'elle n'a pas tranché.
Refuser plutôt que deviner
Un domaine dont les règles ne sont pas chargées sort en « bloquant », jamais en « conforme ». Un statut d'intervention majorée non renseigné n'est pas un « non » : le champ est nullable sans valeur par défaut, pour ne jamais appliquer le tarif ordinaire par omission (ADR-0020). Une logopède non conventionnée sans honoraire saisi obtient un refus explicite, pas un montant approché.
4. La chaîne de production : Pentacore
Aucune ligne de code d'Orthopy n'est acceptée sur la seule parole d'un agent. Pentacore, l'orchestrateur Python que j'ai écrit et que j'utilise sur tous mes projets, dépile une file de tâches rédigées à l'avance :
- La tâche (
task_NNN.md) contient le pourquoi, les décisions déjà tranchées, les tranches de TDD dans l'ordre, les anti-patterns à éviter, ce qui est hors périmètre et les commandes de vérification de clôture. Le contexte n'est pas laissé au hasard : chaque énoncé cadre strictement les fichiers à lire et les fichiers à modifier, évitant l'empilement inutile de tokens. - Un Lead, backend ou frontend, implémente en TDD vertical : un test rouge, le code qui le fait passer, le refactor, puis le test suivant.
- Un Reviewer repasse sur le diff avec une grille adversariale obligatoire : concurrence, cas limites temporels, régressions de validation, performance, trous de tests, impact utilisateur, compatibilité ascendante.
- Un Global Reviewer relit le cycle entier, cherche les défauts résiduels, puis signe le cycle dans un registre. Son périmètre se déduit de ce registre, jamais d'une fenêtre de N commits : un cycle non signé reste à revoir, quel que soit son âge.
- Une passe « coutures » examine à intervalles réguliers les jonctions entre modules, sur plusieurs cycles à la fois.
Un tag de restauration est posé avant chaque tâche. Ce qui exige un œil humain (rendu visuel, accessibilité réelle, parcours d'interaction) est consigné dans une liste de vérifications manuelles, plutôt que coché à l'aveugle par un agent.
Le routage des modèles et le coût d'exécution
Pour alimenter la chaîne sans exploser le budget, j'ai benchmarké plusieurs familles de modèles (Mistral, Gemini, Kimi, Qwen 3.7 27b, Mimo 2.5 pro et la famille GLM 5.X) afin d'évaluer empiriquement le ratio qualité/prix sur des tâches de code réelles.
Le compromis le plus efficace a longtemps orienté vers :
- Qwen 3.7 27b en Lead pour dérouler l'implémentation et le TDD vertical.
- V4 pro en Reviewer (paramétré en raisonnement high), avant de basculer récemment vers 4.1 flash en max : avec un taux de cache hit quasi permanent à plus de 90 %, le coût par tâche devient dérisoire — de l'ordre de 0,10 à 0,15 dollar par tâche.
L'effet sur le rythme se lit dans l'historique : 104 commits en avril, 242 en mai, puis 1 744 en août, quand la chaîne était suffisamment autonome et de confiance pour tourner la nuit et en production constante sans interruption.
Edit : le sujet de ce pipeline sera abordé dans un prochain article.
5. Le moteur de calcul
C'est la pièce la plus dense du backend. scoring_engine.py compte un peu plus de 2 000 lignes, dont une large part consacrée à la validation des données, pour une interface publique de cinq fonctions : load_norms, select_tranche, compute_z_score, resolve_percentile et compute_score.
Trouver la bonne tranche
Selon la batterie, la tranche d'étalonnage dépend de l'âge en mois, du niveau scolaire, ou d'une table INAMI de « choix d'étalonnage » qui croise le niveau et le mois de passation. Ces tables existent sous deux formes, niveau × mois ou périodes seules, et le moteur les résout dans un ordre strict : le niveau d'abord, la période seule en l'absence de niveau correspondant. Les niveaux scolaires français (CP, CE1…) sont traduits grâce aux équivalences publiées par les fiches INAMI, et la traduction est toujours signalée à l'écran. Un niveau ou un mois non couvert donne une tranche non résolue accompagnée d'un avertissement, jamais un repli silencieux sur l'âge.
Calculer selon l'échelle du manuel
Chaque norme déclare son échelle (moyenne et écart-type, percentiles, classes, notes standard centrées sur 10 ou sur 100, seuil) et le sens de sa distribution. Un temps de lecture est « plus haut = moins bien » ; la CHRONODICTEES est un score inversé, déclaré comme tel plutôt que déduit du type d'épreuve. Pour la BALE, les lectures MCLM sont étalonnées en janvier : le score est ajusté selon le mois de passation.
Ne jamais inventer une norme
La résolution passe par une interface NormSource qui a deux implémentations réelles : la bibliothèque de la praticienne et les grilles livrées avec le logiciel. Une norme absente lève NormNotFoundError, une erreur métier qui nomme le sous-test et la tranche : jamais une erreur 500, jamais une valeur devinée.
Les étalonnages des manuels étant sous droits d'éditeur, les 23 grilles livrées ne contiennent plus aucune valeur depuis le 27 août 2026. Chacune décrit la structure de sa batterie et son mode de calcul, avec un type d'échelle établi par une source citable avant d'être écrit (ADR-0034). Les valeurs viennent de la bibliothèque de chaque praticienne, et un score sans norme réelle est bloqué à l'écran.
Tracer et valider
Chaque score enregistré emporte un norm_snapshot : moyenne, écart-type, percentiles et provenance des valeurs réellement utilisées. Modifier une norme ensuite ne change aucun bilan passé, et l'état précédent est archivé dans une table en ajout seul (ADR-0031). Au chargement, chaque grille traverse une batterie de contrôles (structure des tranches, monotonie des percentiles, cohérence entre notes standard et percentiles) : une grille incohérente est rejetée d'emblée, au lieu d'être découverte au milieu d'un bilan.
L'import de normes par OCR suit la même discipline. Le document est traité en tâche de fond, les cellules lues avec une confiance faible sont surlignées, une seconde lecture activable s'affiche à côté de la première, et aucune valeur n'est enregistrée sans confirmation explicite.
Plus de 300 tests automatisés couvrent le seul calcul des scores.
6. Le pseudonymiseur
C'est la pièce que je montrerais en premier à un expert. Le copilote envoie du texte clinique à un modèle de langage : Mistral, hébergé dans l'UE, sous contrat de sous-traitance, sans conservation des données ni entraînement sur celles-ci. Encore faut-il que ce texte ne contienne pas l'identité de l'enfant. La spécification du 5 août 2026 pose le principe : un filtre en sortie ne garantit rien ; une structure qui rend la fuite impossible, si. Elle définit quatre garanties vérifiables.
| Garantie | Nature | Vérifiée par |
|---|---|---|
| G1 — aucune valeur d'identité connue du dossier ne figure dans un envoi | Absolue, fail-closed | Le vérificateur d'egress, à chaque requête |
| G2 — aucun envoi ne part sans passer par le point de passage unique | Structurelle | Le type Clean, contrôlé à l'exécution |
| G3 — le taux de détection des données identifiantes inconnues est mesuré et ne régresse pas | Statistique | Un corpus étalonné, avec seuils bloquants |
| G4 — deux patients au contenu clinique identique produisent des envois indiscernables | Absolue | Un test d'indiscernabilité |
Un test vert qui ne prouvait pas la garantie : le piège des tests unitaires d'anonymisation
Cette architecture a une histoire. Pendant le développement, sur des données fictives, deux champs du copilote, la question posée et l'historique de conversation, partaient vers le modèle externe sans pseudonymisation, et ce pendant des mois.
Une ADR affirmait pourtant que tous les champs de texte libre étaient couverts, et une vingtaine de tests unitaires d'anonymisation passaient au vert. Ils passaient parce qu'ils vérifiaient le scrubber avec sa propre logique interne : un module qui se relit valide ses propres angles morts. Le test vert prouvait que le code s'exécutait sans planter ; il ne prouvait absolument pas l'absence de fuite en conditions réelles.
La leçon a structuré la suite : dans un projet où plusieurs agents écrivent dans le même fichier, la discipline ne tient pas. Il faut de la structure, avec des types garantis à l'exécution et des tests contradictoires d'indiscernabilité.
Six couches
1. Minimisation. Seuls trois attributs du patient peuvent influencer le prompt : l'âge dérivé en années et mois, le niveau scolaire et le bilinguisme réduit à un booléen. L'en-tête des documents (identités, adresses) vit hors du contenu éditable, et un test statique interdit au module du copilote de seulement mentionner l'en-tête : c'est une frontière, pas un filtre.
2. Détection par spans. Trois détecteurs produisent des intervalles typés, départagés par priorité : les identités connues du dossier (priorité 0), un gazetteer de près de 2 000 prénoms français et belges pour les prénoms isolés (10), et des expressions régulières génériques (20). Le gazetteer exige une majuscule initiale : un prénom tapé en minuscules n'est pas détecté, limite assumée pour ne pas masquer « rose » ou « pierre ».
3. Pseudonymes réalistes, puis réhydratation. Sur le chemin du copilote, les noms deviennent des substituts réalistes, tirés de réserves neutres en genre (55 prénoms, 64 noms de famille) par un index HMAC-SHA256 calculé sur un sel qui change chaque jour. Ils restent stables dans une conversation, ce qui préserve la coréférence, sans permettre de profil durable côté fournisseur. La correspondance vit dans un Vault en mémoire, jamais persisté ni journalisé, et la réponse du modèle est réhydratée au dernier moment, dans la réponse HTTP.
4. Le type Clean. Le fournisseur n'accepte qu'un Clean, une sous-classe de str qu'on obtient uniquement par trois fabriques :
class Clean(str):
    __slots__ = ()

def mint_constant(text: str, *, raison: str) -> Clean: ...          # littéraux du code
def mint_scrubbed(text, redactor, known, *, mode="default") -> Clean: ...  # texte d'origine patient
def mint_joined(parts: Sequence[Clean]) -> Clean: ...                 # assemblage de Clean
mint_constant exige une raison : un simple grep donne l'inventaire exhaustif et justifié des 48 textes auxquels le code fait confiance. Un envoi qui n'est pas un Clean lève une TypeError avant d'atteindre le réseau.
5. Le vérificateur d'egress indépendant. C'est la dernière barrière, écrite sans importer une ligne de l'anonymiseur : deux implémentations qui se trompent de la même façon ne vérifient rien. Il « écrase » le texte (normalisation Unicode, suppression des accents, minuscules, alphanumériques seuls) pour attraper M-A-R-I-E, Marié ou un espace de largeur nulle, puis cherche les identités connues du dossier en ancrant le match sur les frontières de mot. Il impose aussi un invariant : aucune suite de 6 chiffres ou plus hors liste blanche (années, codes de nomenclature INAMI, dates valides). En mode block, le mode par défaut, une détection bloque l'envoi.
6. L'accountability. Chaque appel au modèle écrit une ligne JSON dans un journal dédié : le verdict et des compteurs par type de détection, avec les identifiants patient et praticien remplacés par un HMAC, jamais une valeur. Côté observabilité, le hook before_send de Sentry masque les champs sensibles (question, suggestion, historique, transcription) et abandonne l'événement si le masquage échoue.
Mesurer au lieu de supposer
Deux tests changent la nature de la vérification.
Le test d'indiscernabilité construit deux patients à l'identité totalement différente mais au contenu clinique identique, et exige des envois identiques. Toute différence est une fuite, par définition, sans avoir à deviner laquelle. Dès sa première exécution, il a révélé que la langue seconde de l'enfant partait en clair. Or « 7 ans, 2e primaire, bilingue arménien, suspicion de dysphasie » peut suffire à désigner un enfant en Wallonie, sans qu'aucun nom n'apparaisse. La langue est sortie du prompt, et le budget de quasi-identifiants autorisés est désormais explicite (ADR-0024) :
# Extrait de server/tests/test_copilot_indiscernabilite.py
@pytest.mark.asyncio
async def test_langue_seconde_ne_transpire_pas(db):
    # Deux patients bilingues ne différant QUE par leur langue seconde (arménien vs turc)
    a, b = await _make_patient_pair(
        db,
        a=dict(is_bilingual=True, second_language="arménien"),
        b=dict(is_bilingual=True, second_language="turc"),
    )
    clinique = [{"title": "Anamnèse", "content": "Difficultés en conscience phonologique."}]

    pa = canonicalize(_texte((await _build_copilot_contents(db, patient_id=a.id, sections=clinique))[0]))
    pb = canonicalize(_texte((await _build_copilot_contents(db, patient_id=b.id, sections=clinique))[0]))

    assert pa == pb, _diff(pa, pb)
Le corpus étalonné mesure le rappel de détection par type de donnée identifiante, avec des seuils bloquants calibrés juste sous la mesure initiale, et une précision minimale sur des notes qui n'en contiennent pas. Les rappels faibles, comme celui des adresses, sont documentés comme des limites réelles plutôt que maquillés.
S'y ajoutent des tests de propriétés (Hypothesis) sur l'anonymiseur, et des réglages mesurés. L'ancrage du vérificateur sur les frontières de mot a fait passer les faux positifs de 4 à 0 sur 98 prénoms testés, sans perte de détection : auparavant, un enfant prénommé Ilan avait le copilote bloqué en permanence, parce que « son bilan » contient son prénom (ADR-0040).
Les limites, écrites noir sur blanc
- L'audio de dictée est transmis au fournisseur pour transcription (Voxtral). Seule la transcription est ensuite pseudonymisée, avant l'appel au modèle de langage : on ne pseudonymise pas un son qu'on n'a pas encore transcrit.
- La pseudonymisation n'est pas l'anonymisation. Au sens du RGPD (considérant 26), des données pseudonymisées restent des données personnelles. Sur des récits cliniques d'enfants, l'anonymisation juridique est hors d'atteinte : la cible est une pseudonymisation forte, la minimisation, un traitement dans l'UE et une responsabilité démontrable.
- Orthopy n'est pas un dispositif médical marqué CE. J'ai donc restreint le copilote le 24 août : il ne génère plus d'objectifs thérapeutiques à partir des données cliniques et, pour ces objectifs, se limite à reformuler le brouillon écrit par la logopède (ADR-0033). La frontière retenue suit la logique de qualification des logiciels du règlement (UE) 2017/745.
7. Le maillage interne
En août, une revue des parcours cliniques de bout en bout (bilan → conformité → accord → dossier mutuelle → facturation) a posé un constat net : les modules, pris isolément, étaient sains ; les coutures entre eux fuyaient. Près de 2 000 tests passaient, et plusieurs incohérences vivaient pourtant au vert, parce qu'aucun test ne traversait deux modules. Il existait par exemple trois compteurs de séances indépendants. Et le type TypeScript d'un dossier, écrit à la main, annonçait un champ que l'API ne renvoyait pas : l'assistant de demande d'accord était inatteignable, avec une suite entièrement verte.
La réponse n'a pas été une série de correctifs, mais une doctrine.
Dériver, ne pas stocker
Le nombre de séances consommées sur un plan n'existe pas en base : c'est un COUNT des rendez-vous au statut « présent », calculé à la lecture (ADR-0010), en deux requêtes quel que soit le nombre de dossiers. Le type de quota, annuel ou total, se dérive de la pathologie (ADR-0011). La progression de l'onboarding se dérive des faits du domaine par des EXISTS : une quête « créer votre premier patient » est terminée parce qu'un patient existe, pas parce qu'un compteur parallèle l'affirme (ADR-0030). Le mode de panne devient une requête fausse, visible et testable, au lieu d'un état qui diverge en silence.
Un besoin clinique devenu fonctionnalité : « Un document, un propriétaire »
Le réflexe initial d'un développeur consiste à rattacher les pièces justificatives (audiogramme ORL, rapport de QI) au bilan ou à la demande d'accord en cours.
En pratique clinique, c'est une aberration : un audiogramme ou un test de QI est réalisé par un praticien extérieur et reste valable un à deux ans pour plusieurs bilans, renouvellements et prolongations successifs. Rattacher la pièce au bilan forçait la logopède à re-téléverser le même fichier ou à fouiller dans ses archives.
Dans Orthopy, le document médical appartient exclusivement à l'enfant, sous contrainte d'unicité : une seule ligne par couple patient × type de pièce. Déposé une fois, il satisfait chaque bilan qui le réclame, le moteur de conformité INAMI le valide directement, et son retrait défait cette satisfaction de façon symétrique. Le besoin clinique a dicté la modélisation de base de données.
Dans la même logique, une facture naît d'un rendez-vous honoré, avec une contrainte d'unicité stricte sur ce rendez-vous : un double clic ne peut pas créer deux factures.
Figer au bon moment
Un compte-rendu finalisé fige son en-tête (header_snapshot) et sa trame (trame_snapshot) ; un score fige sa norme (norm_snapshot) ; une facture fige ses montants. L'état vivant est dérivé, l'état qui engage est figé, et la frontière entre les deux est à chaque fois une décision explicite.
Une passe de revue dédiée aux coutures
La chaîne elle-même a évolué. Une passe « coutures », confiée à un agent dédié, examine les jonctions entre modules sur plusieurs cycles à la fois, et des sondes de flux métier documentent le comportement réel des parcours de bout en bout. C'est précisément le type de défaut qu'une revue module par module ne peut pas voir.
8. Quand la file s'alimentait elle-même
À partir de la mi-août, la chaîne a développé un travers. Chaque constat d'un reviewer ou d'un contrôle automatique, jusqu'à une phrase de docstring, devenait une nouvelle tâche de nettoyage. La part des cycles de nettoyage est passée de 12 % la semaine du 3 août à 60 % la semaine du 7 septembre, et certains jours, dix tâches de nettoyage étaient créées. La file se nourrissait de ses propres constats.
Le 11 septembre, j'ai corrigé la règle au lieu d'en ajouter une nouvelle : les passes restent des jalons fixes, et la correction devient la règle. Un reviewer corrige sur place tout ce qu'il peut prouver par exécution. Seuls une migration, un contrat public impossible à aligner ou un arbitrage métier partent en tâche. Les familles sensibles (données de santé, RGPD, cloisonnement des données, faux vert) sont toujours signalées, mais peuvent être corrigées directement. Dans l'orchestrateur, les constats des contrôles automatiques vont désormais au Global Reviewer au lieu de créer des tâches, et deux gardes ont été ajoutées le 13 septembre : un stage déclaré réussi sans rapport arrête la chaîne, et le travail d'un Lead est commité avant le passage de son Reviewer.
Depuis la correction, la file ne s'alimente plus d'elle-même : deux ou trois tâches de nettoyage par jour, contre dix certains jours de fin août et de début septembre.
9. La mise en ligne (septembre 2026)
Prouver avant de déployer
- La portabilité PostgreSQL, prouvée le 16 août sur un PostgreSQL 16 jetable :
alembic upgrade headintégral, démarrage de l'API, inscription et connexion réelles, zéro erreur. Le 10 septembre, la suite backend complète tournait sur PostgreSQL 16 sans aucune régression propre à la base. - La bonne mesure. Le 10 septembre, plutôt que de compter les tests verts, j'ai mesuré l'avancement de l'exploitation et du test humain des parcours. Des milliers de tests verts et des notes de revue stables ne disent pas si un projet approche de sa sortie. C'est ce constat qui a déclenché la mise en ligne.
L'infrastructure
- Une petite instance Scaleway en région Paris, avec Docker Compose en production : Caddy, frontend, backend, PostgreSQL, Redis et un service de sauvegarde.
- Caddy est le seul à publier les ports 80 et 443 : certificats Let's Encrypt renouvelés automatiquement, TLS 1.3, redirection vers HTTPS et HSTS. La documentation interactive de l'API n'est pas exposée en production.
- CORS strict, avec une garde au démarrage qui refuse en production un joker, une origine en HTTP,
localhostou un chemin dans la liste des origines autorisées. - Sentry pour les erreurs, avec le masquage décrit plus haut.
- Des sauvegardes chaque nuit vers un stockage objet privé, hors du serveur. Une sauvegarde a été restaurée dans une base jetable : mêmes 43 tables, même nombre de lignes, même version de migration.
- L'accès bêta exige un code d'invitation, une bannière « environnement de test » reste affichée en permanence, et le script de données de démonstration refuse de s'exécuter en production, parce qu'il crée un compte au mot de passe connu.
- Chaque déploiement porte une étiquette git
deploy/<env>-<date>. Ce qui n'est pas encore en production se lit avecgit log <dernière étiquette>..main.
Les pièges d'exploitation
- Le Caddyfile est monté comme un fichier unique. Un
git pullle remplace par un nouvel inode ; le conteneur continue de lire l'ancien, etcaddy reloadaussi. Il faut valider le nouveau fichier avec le Caddy du conteneur, puis redémarrer le conteneur. - Un heredoc SSH peut avaler la fin d'un script. Dans
ssh … 'bash -s' <<'EOF', undocker compose exec -Tlit la suite du heredoc sur son entrée standard : les commandes suivantes disparaissent sans la moindre erreur. D'où un</dev/nullsystématique. - Un build frontend sur une petite machine prend près de six minutes et fait swapper l'hôte. Lancé par
systemd-run, il survit à la coupure de la session SSH, à condition de passer--working-directory: l'unité démarre dans/. - La délivrabilité ne se décrète pas. La première invitation a bien été acceptée par Microsoft, qui l'a pourtant rangée dans les indésirables : domaine neuf, aucun en-tête
Date, un long lien brut suivi d'un code. Correctif : des en-têtesDateetMessage-IDsur chaque message, et un bouton à la place du lien brut. La réputation du domaine, elle, se construit avec le temps.
Le premier bug de bêta
Le soir de la mise en ligne, la logopède consultante n'a pas pu enregistrer un patient : POST /api/patients répondait 422. Depuis un durcissement de la validation, un sélecteur de niveau scolaire laissé vide envoyait school_grade: "", désormais refusé. Correctif côté backend ("" normalisé en None) et côté frontend, redéployé et vérifié en production 48 minutes après l'erreur.
10. Ce que je referais autrement
- Tester les coutures dès le premier jour. Les tests de module ne voient pas ce qui se passe entre les modules.
- Générer les types du frontend depuis le schéma OpenAPI, au lieu de les écrire à la main : l'assistant inatteignable n'aurait jamais existé.
- Lancer l'exploitation plus tôt. Le code a été jugé prêt fin août, l'infrastructure a suivi ensuite. Une instance de démonstration mise en ligne plus tôt aurait fait remonter plus vite les vrais problèmes, comme celui du premier soir.
- Mesurer la convergence plutôt que le volume. Le ratio de cycles de nettoyage m'en a dit davantage sur l'état du projet que le nombre de tests verts.
En résumé
Orthopy est en bêta fermée sur orthopy.be, et le récit côté produit se trouve dans l'étude de cas.
Ce projet prouve qu'un développeur seul peut concevoir et mettre en production un SaaS clinique complexe avec des agents, à une condition : déplacer l'effort de la frappe du code vers l'architecture des garde-fous et la rigueur de la preuve.
Sources
- Règlement général sur la protection des données — Règlement (UE) 2016/679 : article 4, point 5 (pseudonymisation), article 32 et considérant 26.
- Règlement relatif aux dispositifs médicaux — Règlement (UE) 2017/745, notamment l'annexe VIII, règle 11, sur les logiciels.
- INAMI — Listes limitatives des tests en logopédie.
- INAMI — Informations pour les logopèdes : nomenclature, compendium, honoraires.
- John Ousterhout, A Philosophy of Software Design, Yaknyam Press, 2018 : la notion de module profond.